


人效项目落地路线图:为什么必须分阶段推进?
人效项目最容易出现的一种失败,不是系统不好用,而是一上来就全厂铺开:数据没清洗、规则没对齐、班组长没适应,试点没跑通就强制推广,最后用户抵触、指标口径乱、项目烂尾。
对多工厂、多业态的制造企业来说,更稳的节奏通常是「1–3 个月试点、4–6 个月推广、7–12 个月深化」。人效项目没有捷径,但路线对了,每一步都算数。
一、为什么必须分阶段
人效不是单点功能上线,而是「数据 + 规则 + 组织习惯」一起变。直接全量铺开,通常会踩三个坑:
组织复杂度高:多工厂、多产线、多业态,排班规则和工时口径差异大
数据质量不足:人员主数据、技能标签、历史工时、班次模板往往需要先清洗
用户习惯未建立:一线班组长需要时间接受新工具,否则系统排了也不照用
分阶段的核心目的,不是拖进度,而是把不确定性留在小范围里先暴露、先解决。
二、第一阶段(1–3 个月):试点跑通
选点标准
选 1–2 家痛点突出、配合度高的工厂或车间,不建议一上来选最复杂的产线——复杂度太高会分不清是项目问题还是业务问题。
核心动作
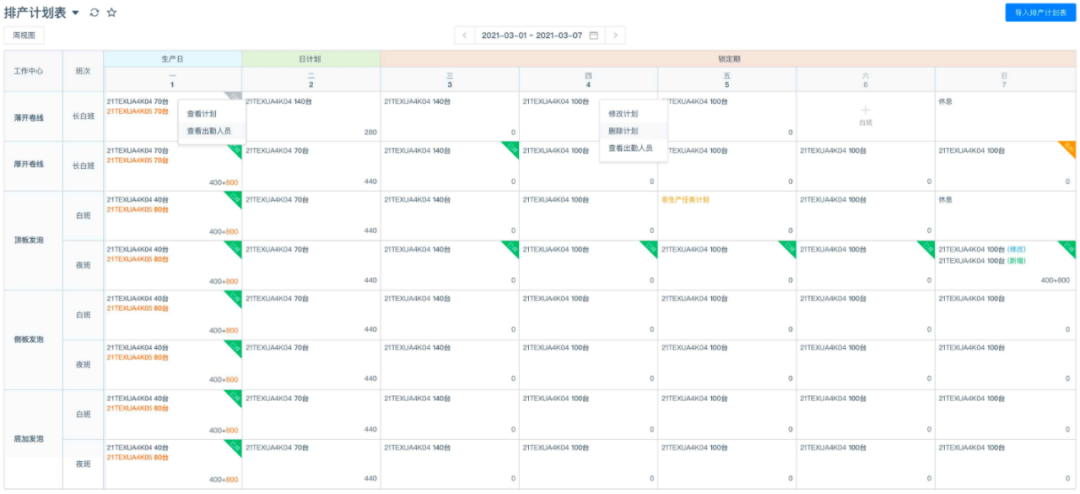
人员、组织、技能、班次模板、岗位 SOP 初始化
MES / ERP / WMS 基础对接,核心排班功能上线
跑通「生产计划 → 排班规则 → 班表发布」
培训关键用户(车间主任、排班员、HR 对接人)
产出第一批可核对的实际工时数据
本阶段交付物
试点车间排班表稳定运行
主数据口径清单
异常规则初版(缺岗、超时、技能不匹配)
关键用户操作手册
三、第二阶段(4–6 个月):推广覆盖
试点验证通过后,再往剩余工厂和营运中心推。
统一各工厂排班规则与指标口径
跨厂支援引擎、分段排班等功能按需开启
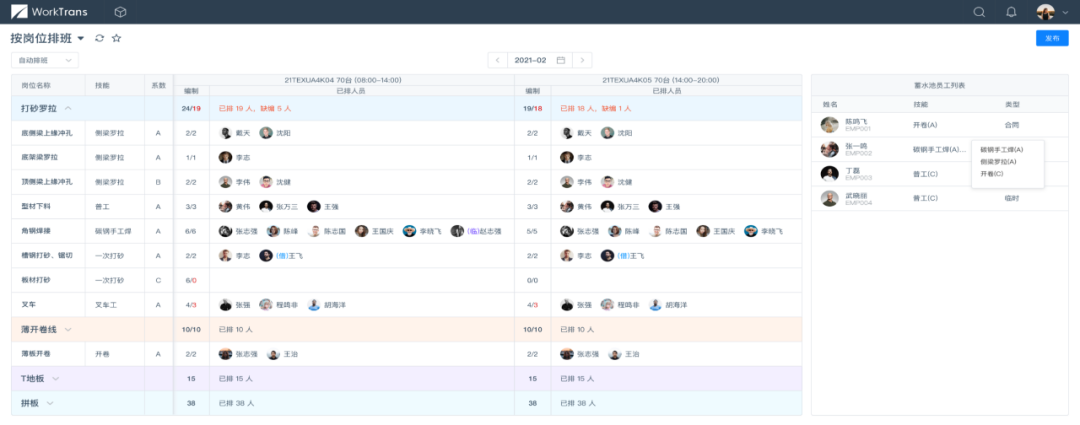
移动端班表下发、调班审批、异常预警上线
管理层看板:工时率、加班率、缺编率、人效基线
推广不是把试点配置原样复制,而是复制「方法论 + 数据框架」。
四、第三阶段(7–12 个月):深化优化
基于历史数据训练排班预测模型(工单 / 产能 / 客流)
精益工时分析:直接工时、间接工时、损耗工时拆分
计划 → 排班 → 考勤 → 薪资全链路自动核对
人效指标进入月度经营复盘
注意:AI 排班模型必须放在数据口径稳定之后。主数据没清完就上模型,输出结果只是「看起来高级的错误」。
五、试点选厂 5 个标准
| 维度 | 建议 |
|---|---|
| 痛点强度 | 工时异常、加班高、缺岗频繁 |
| 管理层支持 | 能配专职项目对接人 |
| 数据基础 | 已有 MES / ERP 基础数据 |
| 复杂度 | 适中,不选最复杂产线 |
| 代表性 | 后续可复制到其他工厂 |
六、成功关键因素
数据:主数据标准是地基,宁可前期多花 2 周清洗
集成:MES / ERP / WMS / 考勤 / 薪酬不通,人效就闭不了环
变革:班组长不是被系统替代,而是少做重复填表、多做异常决策
节奏:试点要小、推广要稳、优化要持续
七、常见误区
「先全厂上线再调」
人效项目最忌这个。全厂铺开后规则错了,改一次要动几千人排班。
「系统排了就行」
系统只解决匹配,业务突变还得班组长确认。预警没人处理,比没有预警更糟。
「人效 = 裁人」
人效项目不是压缩编制运动。先看清缺口和冗余在哪,再决定补、调、训、并。
某食品生产基地按上述三阶段推进人效项目,目标是对齐集团人效指标口径,先把单厂排班规则跑通,再逐步复制到多工厂场景。
了解更多排班与工时成本方案:喔趣智能排班
 沈**